RAG là gì? Cách giúp AI trả lời dựa trên dữ liệu của bạn
Khi các doanh nghiệp và chuyên gia công nghệ bắt đầu ứng dụng mô hình ngôn ngữ lớn (LLM) vào vận hành thực tế, một rào cản lớn nhanh chóng lộ diện: AI rất giỏi làm thơ, tóm tắt tin tức hay giải thích các nguyên lý phổ quát, nhưng lại hoàn toàn “mù tịt” trước kho dữ liệu nội bộ của bạn. Nếu hỏi ChatGPT hay Claude về chính sách bảo hành riêng của công ty, quy trình hoàn thuế nội bộ năm nay, hoặc báo cáo tài chính quý gần nhất, câu trả lời thường là sự từ chối hoặc tệ hơn: một câu trả lời bịa đặt nhưng nghe vô cùng thuyết phục.
Hiện tượng này được ngành công nghệ gọi là ảo giác AI (AI Hallucination). Các mô hình ngôn ngữ vốn chỉ suy luận dựa trên dữ liệu tĩnh được nạp trong quá trình huấn luyện quá khứ. Chúng không có mắt để nhìn vào tệp PDF, bảng tính Excel, hay kho tài liệu Notion của tổ chức bạn, trừ khi có một cây cầu kỹ thuật bắc qua khoảng trống đó.
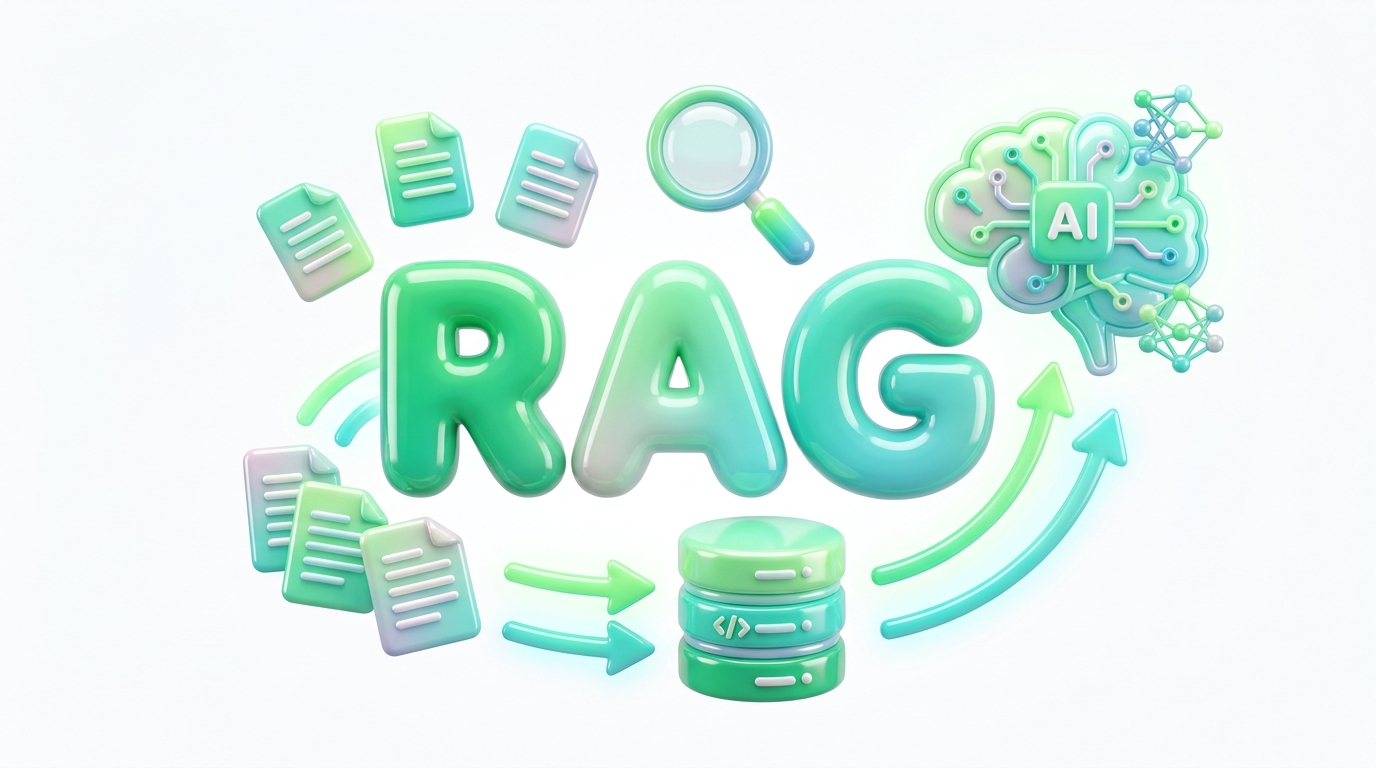
Đó chính là lý do RAG (Retrieval-Augmented Generation – Tạo sinh tăng cường truy xuất) ra đời và trở thành kiến trúc công nghệ quan trọng bậc nhất trong kỷ nguyên GenAI. RAG biến một mô hình ngôn ngữ thông minh thông thường thành một chuyên gia am hiểu tường tận từng trang tài liệu của riêng bạn mà không đòi hỏi chi phí huấn luyện lại hàng triệu USD.
Trong bài viết chuyên sâu này thuộc chuyên mục AI trên TrungTien.net, chúng ta sẽ cùng bóc tách toàn diện về RAG: từ định nghĩa học thuật, đường ống kiến trúc 3 bước (Retrieve – Augment – Generate), kỹ thuật Embedding và Vector Database, chiến lược phân đoạn dữ liệu (Chunking), cho đến bảng so sánh RAG với Fine-tuning và Long Context, cùng cẩm nang ứng dụng thực tế cho doanh nghiệp.
1. RAG là gì? Khái niệm và bản chất cốt lõi
RAG (Retrieval-Augmented Generation), dịch sang tiếng Việt là Tạo sinh tăng cường truy xuất, là một kỹ thuật kiến trúc trong trí tuệ nhân tạo nhằm tối ưu hóa đầu ra của mô hình ngôn ngữ lớn (LLM) bằng cách tham chiếu đến một nguồn tri thức bên ngoài đáng tin cậy trước khi sinh ra câu trả lời.
Khái niệm RAG được giới thiệu lần đầu tiên vào năm 2020 trong công trình nghiên cứu mang tính bước ngoặt của nhóm tác giả Patrick Lewis và các đồng sự tại Meta AI Research, hợp tác cùng University College London và New York University với tiêu đề “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks”. Ban đầu, nghiên cứu này nhằm giải quyết các bài toán trả lời câu hỏi đòi hỏi tri thức chuyên sâu mà các mô hình dạng Seq2Seq thời bấy giờ gặp khó khăn.
Để hiểu rõ bản chất của RAG, chúng ta cần phân biệt hai dạng tri thức trong hệ thống trí tuệ nhân tạo hiện đại:
- Tri thức tham số (Parametric Memory): Là toàn bộ kiến thức được “khắc” trực tiếp vào hàng trăm tỷ trọng số (weights) của mạng nơ-ron trong quá trình tiền huấn luyện (Pre-training). Tri thức này mang tính tổng quát, cố định theo thời gian và cực kỳ tốn kém nếu muốn cập nhật mới.
- Tri thức phi tham số (Non-parametric Memory): Là kho tài liệu độc lập nằm ở bên ngoài mô hình, bao gồm các cơ sở dữ liệu quan hệ, kho tài liệu văn bản, tệp PDF nội bộ, và đặc biệt là cơ sở dữ liệu vector (Vector Database). Nguồn tri thức này có thể cập nhật, chỉnh sửa, thêm bớt theo thời gian thực mà không làm thay đổi bất kỳ trọng số nào của mô hình.
Một phép so sánh trực quan rất phổ biến trong cộng đồng nghiên cứu AI: Một mô hình LLM đơn thuần giống như một sinh viên bước vào phòng thi chỉ được dựa vào trí nhớ học vẹt từ nhiều tháng trước. Sinh viên đó có thể nhớ lờ mờ một công thức rồi tự sáng tác ra phần còn lại để nộp bài (ảo giác). Ngược lại, một hệ thống kết hợp RAG giống như một kỳ thi mở (open-book exam). Trước khi viết đáp án, sinh viên được phép chạy vào thư viện, rút đúng 3 trang tài liệu liên quan nhất đến câu hỏi, đọc kỹ và trích dẫn chuẩn xác từng điều khoản vào bài làm.
2. Tại sao doanh nghiệp và lập trình viên cần đến RAG?
Mặc dù các mô hình nền tảng như GPT-4o, Claude 3.5 Sonnet hay Gemini 1.5 Pro ngày càng thông minh, chúng vẫn mang những giới hạn tự nhiên không thể khắc phục nếu chỉ đứng một mình. Dưới đây là 4 lý do sống còn khiến RAG trở thành tiêu chuẩn bắt buộc cho ứng dụng doanh nghiệp:
Khắc phục giới hạn tri thức theo thời gian (Knowledge Cutoff)
Mỗi mô hình AI đều có một thời điểm “chốt sổ” dữ liệu huấn luyện. Ví dụ, một mô hình có hạn tri thức đến tháng 4 năm 2024 sẽ không thể biết được các thông tư pháp lý ban hành vào năm 2025 hoặc 2026. Với RAG, bất cứ khi nào có chính sách mới, bạn chỉ cần nạp văn bản đó vào cơ sở dữ liệu ngoài. Hệ thống sẽ tự động truy xuất và trả lời chính xác ngay lập tức mà không cần chờ đợt huấn luyện tiếp theo của nhà cung cấp mô hình.
Triệt tiêu ảo giác và đảm bảo tính minh bạch có thể kiểm chứng
Trong các lĩnh vực đòi hỏi độ chính xác tuyệt đối như y tế, pháp lý, tài chính hay kỹ thuật công nghiệp, một câu trả lời sai lệch có thể dẫn tới hậu quả thảm khốc. RAG giải quyết bài toán này bằng cách buộc mô hình phải bám sát (grounded) vào ngữ cảnh được cung cấp. Hơn thế nữa, hệ thống RAG có thể đính kèm nguồn trích dẫn cụ thể (ví dụ: “Theo Điều 12, Khoản 3, Hợp đồng lao động số 45/2025”) để người dùng có thể nhấp chuột kiểm tra chéo nguồn gốc thông tin.
Bảo vệ dữ liệu bí mật nội bộ và quyền riêng tư
Nhiều tổ chức e ngại việc gửi dữ liệu nhạy cảm lên các máy chủ công cộng để fine-tune mô hình vì nguy cơ rò rỉ dữ liệu hoặc bị sử dụng để huấn luyện mô hình cho đối thủ. Với RAG, dữ liệu doanh nghiệp có thể được lưu trữ hoàn toàn trên hạ tầng riêng (on-premise) hoặc môi trường đám mây có kiểm soát nghiêm ngặt. Mô hình AI chỉ nhận được các đoạn trích ngắn gọn cần thiết cho câu hỏi hiện tại thông qua các kênh mã hóa an toàn.
Tiết kiệm chi phí đầu tư hạ tầng khổng lồ
Huấn luyện lại (re-training) hoặc tinh chỉnh toàn diện (full fine-tuning) một mô hình ngôn ngữ lớn tiêu tốn từ hàng chục nghìn đến hàng triệu USD chi phí thuê cụm GPU chuyên dụng (như NVIDIA H100, B200), kèm theo đội ngũ kỹ sư dữ liệu tay nghề cao. Trong khi đó, việc dựng một đường ống RAG cơ bản có chi phí vận hành cực kỳ thấp, tận dụng được các API mô hình sẵn có và chỉ tốn vài chục USD tiền lưu trữ vector mỗi tháng.
3. Kiến trúc tổng thể của RAG: Pipeline 3 bước Retrieve – Augment – Generate
Về mặt kỹ thuật, một hệ sinh thái RAG tiêu chuẩn vận hành dựa trên hai chu trình tách biệt nhưng phối hợp nhịp nhàng: Chu trình chuẩn bị dữ liệu ngoại tuyến (Offline Ingestion Pipeline) và Chu trình truy vấn trực tuyến (Online Inference Pipeline).
Chu trình ngoại tuyến (Offline Ingestion & Indexing Pipeline)
Chu trình này diễn ra trước khi người dùng thực hiện bất kỳ câu hỏi nào. Mục tiêu của nó là biến kho tài liệu hỗn tạp của doanh nghiệp thành một thư viện vector có cấu trúc:
- Thu thập dữ liệu (Data Ingestion): Thu nạp tài liệu từ nhiều định dạng khác nhau như PDF, Word (.docx), bảng tính Excel, bài viết trên Confluence, Notion, hoặc các bản ghi từ cơ sở dữ liệu quan hệ (PostgreSQL, MySQL).
- Làm sạch và chuẩn hóa (Text Extraction & Cleaning): Trích xuất văn bản thuần túy, loại bỏ các thẻ HTML rác, ký tự điều khiển vô nghĩa, sửa lỗi giải mã UTF-8 và trích xuất cấu trúc bảng biểu nếu có.
- Phân đoạn tài liệu (Chunking): Cắt các tài liệu dài thành nhiều mẩu văn bản nhỏ (chunks) có độ dài vừa phải, kèm theo siêu dữ liệu (metadata) như tiêu đề tài liệu, tác giả, ngày tạo, số trang.
- Mã hóa ngữ nghĩa (Embedding Generation): Đưa từng chunk văn bản qua một mô hình nhúng (Embedding Model) để biến đổi chuỗi từ ngữ thành một chuỗi số thực nhiều chiều (vector embedding).
- Lưu trữ vào Vector Database: Nạp các vector cùng văn bản gốc và metadata tương ứng vào cơ sở dữ liệu vector chuyên dụng, tiến hành đánh chỉ mục (indexing) để phục vụ tra cứu tốc độ cao.
Chu trình trực tuyến (Online Query & Generation Pipeline)
Khi một người dùng nhập câu hỏi vào hệ thống, chu trình trực tuyến sẽ được kích hoạt theo đúng 3 bước nền tảng của RAG:
- Bước 1 – Retrieve (Truy xuất): Câu hỏi của người dùng được gửi qua mô hình Embedding (chính là mô hình đã dùng ở chu trình ngoại tuyến) để tạo thành một Query Vector. Cơ sở dữ liệu vector lập tức thực hiện phép tính khoảng cách không gian (Similarity Search) để tìm ra Top-K đoạn văn bản (thường từ 3 đến 7 đoạn) có ngữ nghĩa liên quan nhất đến câu hỏi.
- Bước 2 – Augment (Bổ sung ngữ cảnh): Hệ thống lấy Top-K đoạn văn bản vừa tìm được và chèn trực tiếp vào một khuôn mẫu Prompt (Prompt Template) có cấu trúc chặt chẽ. Prompt này định hướng rõ ràng: “Hãy đóng vai một trợ lý chuyên nghiệp. Dưới đây là các tài liệu tham khảo chính thức. Hãy chỉ sử dụng thông tin trong tài liệu này để trả lời câu hỏi của người dùng. Nếu thông tin không có trong tài liệu, hãy từ chối lịch sự.”
- Bước 3 – Generate (Tạo sinh): Toàn bộ Prompt đã được tăng cường ngữ cảnh được gửi đến mô hình ngôn ngữ lớn (như GPT-4o, Claude hay Llama 3). LLM đọc hiểu ngữ cảnh được nạp và tổng hợp nên câu trả lời tự nhiên, chính xác, đính kèm dẫn chứng cụ thể cho người dùng.
4. Trái tim của RAG: Embedding và Vector Database
Nếu không có Embedding và Vector Database, kỹ thuật RAG không thể tồn tại. Đây chính là cặp đôi công nghệ mang lại khả năng “hiểu ngữ nghĩa” thay vì chỉ tìm kiếm từ khóa khô khan như các công cụ tìm kiếm truyền thống.
Vector Embedding là gì?
Con người giao tiếp bằng từ ngữ, nhưng máy tính chỉ hiểu các con số. Vector Embedding là một phương pháp toán học giúp ánh xạ từ ngữ, câu văn hoặc đoạn văn thành một mảng các số thực (vector) trong một không gian hình học đa chiều (thường từ vài trăm đến vài nghìn chiều, ví dụ 1536 chiều đối với OpenAI text-embedding-3-small).
Đặc tính kỳ diệu của Vector Embedding nằm ở chỗ: những văn bản có ý nghĩa tương đồng sẽ nằm gần nhau trong không gian đa chiều, ngay cả khi chúng không chia sẻ bất kỳ từ ngữ chung nào. Ví dụ: câu "Làm sao để lấy lại mật khẩu?" và câu "Tôi bị mất password đăng nhập" sử dụng bộ từ vựng hoàn toàn khác nhau, nhưng vector của chúng có khoảng cách hình học cực kỳ gần nhau.
Để đo lường khoảng cách giữa các vector trong không gian, hệ thống RAG thường sử dụng 3 công thức hình học phổ biến:
- Cosine Similarity (Độ tương đồng Cosin): Đo góc giữa hai vector bất kể độ dài của chúng. Giá trị dao động từ -1 đến 1 (với văn bản thường từ 0 đến 1). Đây là phương pháp phổ biến và ổn định nhất trong xử lý ngôn ngữ tự nhiên.
- Dot Product (Tích vô hướng): Tính tổng tích các phần tử tương ứng của hai vector. Nếu vector đã được chuẩn hóa độ dài (normalized), Dot Product tương đương với Cosine Similarity nhưng có tốc độ tính toán phần cứng cực nhanh.
- Euclidean Distance (Khoảng cách L2): Đo khoảng cách đường thẳng vật lý giữa hai điểm tọa độ. Giá trị càng nhỏ thể hiện mức độ tương đồng càng cao.
Vector Database là gì và tại sao SQL truyền thống gặp khó?
Cơ sở dữ liệu quan hệ truyền thống (SQL) được thiết kế tối ưu cho các truy vấn chính xác: WHERE age > 25 hoặc WHERE username = 'trungtien'. Khi tìm kiếm văn bản, SQL chỉ có thể dùng lệnh LIKE '%từ_khóa%' hoặc Full-Text Search dựa trên tần suất từ (BM25, TF-IDF). Cách tiếp cận này hoàn toàn thất bại khi người dùng đặt câu hỏi bằng từ đồng nghĩa, từ lóng hoặc diễn đạt theo ngữ cảnh gián tiếp.
Vector Database được sinh ra để chuyên trị bài toán tìm kiếm lân cận xấp xỉ (Approximate Nearest Neighbors – ANN). Thay vì quét tuần tự hàng triệu dòng dữ liệu (Linear Scan rất chậm), Vector Database sử dụng các cấu trúc đồ thị và cây chỉ mục tiên tiến như HNSW (Hierarchical Navigable Small World) hay IVF (Inverted File Index) để tìm ra Top-K vector gần nhất chỉ trong vài mili-giây.
Dưới đây là bảng phân tích các giải pháp Vector Database hàng đầu trên thị trường hiện nay:
| Tên Vector Database | Bản quyền / Hình thức | Ngôn ngữ phát triển | Điểm mạnh nổi bật | Trường hợp sử dụng tối ưu |
|---|---|---|---|---|
| Qdrant | Mã nguồn mở / Cloud | Rust | Tốc độ cực nhanh, hỗ trợ lọc Payload mạnh, tích hợp Hybrid Search hoàn hảo. | Hệ thống RAG doanh nghiệp từ trung bình đến lớn, đòi hỏi lọc metadata phức tạp. |
| Pinecone | Thương mại hoàn toàn (SaaS) | Độc quyền | Mô hình Serverless tiện lợi, không cần quản trị hạ tầng, tự động co giãn. | Nhóm phát triển muốn triển khai sản phẩm thần tốc, không muốn bận tâm vận hành. |
| Milvus | Mã nguồn mở / Cloud (Zilliz) | Go / C++ | Kiến trúc phân tán siêu mạnh, xử lý được quy mô hàng tỷ vector, tính sẵn sàng cao. | Tập đoàn lớn, ngân hàng, viễn thông với khối lượng dữ liệu khổng lồ cấp độ Big Data. |
| ChromaDB | Mã nguồn mở | Python / C++ | Cực kỳ đơn giản, cài đặt bằng 1 lệnh pip, chạy nhúng (embedded) ngay trong bộ nhớ. | Thử nghiệm dự án (PoC), nghiên cứu học tập, ứng dụng chạy cục bộ trên máy cá nhân. |
| PostgreSQL + pgvector | Mã nguồn mở | C (Extension) | Tận dụng luôn hệ CSDL quan hệ sẵn có, không cần duy trì thêm một hệ thống thứ hai. | Doanh nghiệp đã dùng Postgres, dữ liệu vector dưới vài triệu bản ghi, tối ưu chi phí. |
5. Chiến lược phân đoạn dữ liệu (Chunking Strategies) – Yếu tố quyết định 80% chất lượng RAG
Một sai lầm kinh điển của những người mới làm RAG là nạp nguyên một tệp tài liệu 100 trang vào mô hình embedding, hoặc chia văn bản một cách tùy tiện. Nếu chia đoạn văn bản quá lớn, thông tin cốt lõi sẽ bị pha loãng trong một vector mờ nhạt. Nếu chia đoạn văn bản quá nhỏ, câu văn sẽ bị ngắt vụn, mất đi ngữ cảnh mạch lạc khiến LLM không thể đưa ra câu trả lời thấu đáo.
Lựa chọn chiến lược phân đoạn dữ liệu (Chunking Strategy) phù hợp quyết định tới 80% độ chính xác của hệ thống RAG. Dưới đây là 5 phương pháp phân đoạn thực chiến bạn cần nắm vững:
1. Fixed-size Chunking kết hợp Overlap
Đây là phương pháp cơ bản và dễ triển khai nhất. Tài liệu được cắt thành các khối có số lượng ký tự hoặc token cố định (ví dụ: 500 token mỗi chunk). Điểm mấu chốt là phải thiết lập một vùng giao thoa (Chunk Overlap, thường từ 10% đến 20%, tương đương 50-100 token) giữa hai chunk kế tiếp.
Vùng overlap này đảm bảo rằng nếu một câu văn hoặc một ý niệm quan trọng nằm ngay tại ranh giới cắt, nó sẽ không bị đứt đoạn hoàn toàn mà vẫn xuất hiện trọn vẹn ở ít nhất một trong hai chunk.
2. Sentence & Paragraph Chunking (Phân đoạn theo cấu trúc ngữ pháp)
Thay vì đếm số token cơ học, phương pháp này sử dụng các thư viện xử lý ngôn ngữ tự nhiên (như spaCy, NLTK hoặc regex thông minh) để nhận biết điểm kết thúc câu (dấu chấm, chấm hỏi, chấm than) hoặc điểm kết thúc đoạn văn (hai dấu xuống dòng
). Các câu liên tiếp được gộp lại cho đến khi đạt giới hạn token mong muốn, đảm bảo không có câu văn nào bị xẻ đôi giữa chừng.
3. Document-Structure Chunking (Phân đoạn theo cấu trúc phân cấp)
Đối với các tài liệu có cấu trúc rõ ràng như tệp Markdown, HTML, JSON hoặc tài liệu kỹ thuật có đề mục, phương pháp này cắt dữ liệu dựa trên các thẻ tiêu đề (H1, H2, H3). Mỗi chunk sẽ đại diện cho một tiểu mục hoàn chỉnh.
Đặc biệt, hệ thống sẽ tự động gắn đường dẫn phân cấp vào metadata của từng chunk (ví dụ: Chương 3 > Mục 2.1 > Điều khoản thanh toán). Nhờ đó, mô hình AI luôn biết chính xác đoạn văn này thuộc bối cảnh lớn nào của văn bản.
4. Semantic Chunking (Phân đoạn dựa trên sự biến thiên ngữ nghĩa)
Đây là kỹ thuật phân đoạn thông minh nâng cao. Thay vì dựa vào độ dài hay dấu câu, thuật toán sẽ tính toán vector embedding cho từng câu văn đơn lẻ, sau đó so sánh khoảng cách cosin giữa các câu liên tiếp. Chừng nào khoảng cách ngữ nghĩa giữa các câu vẫn nhỏ, chúng thuộc về cùng một chủ đề và được gom chung.
Khi khoảng cách giữa câu n và câu n+1 tăng vọt vượt ngưỡng cho phép (threshold), thuật toán nhận diện rằng tác giả vừa chuyển sang một chủ đề mới và sẽ thực hiện thao tác ngắt đoạn ngay tại vị trí đó.
5. Parent-Document Retrieval (Kỹ thuật Small-to-Big Retrieval)
Đây là một trong những giải pháp tối ưu nhất để giải quyết mâu thuẫn giữa việc tìm kiếm và tạo sinh. Ý tưởng cốt lõi: Đoạn văn dùng để tìm kiếm nên nhỏ gọn để khớp ngữ nghĩa chính xác, nhưng đoạn văn gửi cho LLM đọc nên rộng lớn để giữ trọn vẹn ngữ cảnh.
Hệ thống sẽ chia tài liệu thành các khối cha (Parent Chunks) lớn (ví dụ 1000 – 1500 token), sau đó tiếp tục băm mỗi khối cha thành nhiều khối con (Child Chunks) nhỏ (ví dụ 150 – 200 token). Khi tìm kiếm vector, hệ thống chỉ so khớp trên các khối con nhỏ. Nhưng một khi tìm ra khối con phù hợp nhất, hệ thống sẽ tự động truy xuất toàn bộ khối cha tương ứng để nạp vào prompt cho LLM. Kỹ thuật này nâng cao độ chính xác lên gấp nhiều lần so với các phương pháp truyền thống.
6. So sánh toàn diện: RAG vs. Fine-tuning vs. Long Context LLMs
Khi bắt tay xây dựng ứng dụng AI với dữ liệu nội bộ, các kỹ sư thường phân vân giữa ba con đường: Xây dựng RAG, Tinh chỉnh mô hình (Fine-tuning), hoặc Tận dụng cửa sổ ngữ cảnh siêu lớn (Long Context Window) như Gemini 1.5 Pro (2 triệu tokens) hay Claude 3.5 Sonnet (200.000 tokens). Bảng đối chiếu dưới đây sẽ làm rõ bức tranh tổng thể:
| Tiêu chí so sánh | RAG (Retrieval-Augmented) | Fine-Tuning (Tinh chỉnh mô hình) | Long Context LLMs (Cửa sổ lớn) |
|---|---|---|---|
| Mục đích cốt lõi | Bổ sung kiến thức động từ bên ngoài, tra cứu thông tin chính xác. | Dạy mô hình phong cách viết, văn phong, cấu trúc đầu ra hoặc thuật ngữ hẹp. | Xử lý toàn bộ tài liệu lớn trong một lần truy vấn tức thời. |
| Cập nhật tri thức mới | Thời gian thực. Chỉ cần thêm file vào cơ sở dữ liệu là dùng được ngay. | Chậm và tốn kém. Phải chuẩn bị tập dữ liệu cặp Q&A và chạy huấn luyện lại. | Tức thời cho phiên làm việc hiện tại, nhưng phải tải lại toàn bộ tài liệu mỗi lần hỏi. |
| Kiểm soát ảo giác | Rất tốt. Mô hình bị trói buộc vào tài liệu tham khảo cung cấp kèm. | Trung bình. Mô hình vẫn có thể bịa đặt thông tin khi gặp câu hỏi lạ. | Khá tốt, nhưng có thể bị hiện tượng “Lost in the Middle” bỏ sót chi tiết ở giữa. |
| Trích dẫn nguồn (Citations) | Dễ dàng. Xác định chính xác đoạn văn, tệp tin và trang gốc tham chiếu. | Hầu như không thể. Kiến thức đã hòa tan vào hàng tỷ trọng số toán học. | Khó khăn và không ổn định khi văn bản quá dài. |
| Chi phí vận hành mỗi truy vấn | Thấp. Chỉ tốn phí embedding câu hỏi + phí token của Top-K chunks nhỏ. | Thấp. Chỉ tốn phí suy luận (inference) thông thường. | Cực kỳ đắt đỏ. Mỗi câu hỏi phải gửi kèm hàng trăm nghìn đến triệu tokens. |
| Độ trễ phản hồi (Latency) | Thấp đến trung bình (thường từ 1 – 3 giây cho toàn bộ pipeline). | Rất nhanh (chỉ phụ thuộc vào tốc độ sinh văn bản của model). | Rất chậm (phải chờ mô hình xử lý chuỗi ngữ cảnh khổng lồ trước khi trả lời). |
| Phân quyền truy cập (RBAC) | Rất linh hoạt. Lọc metadata theo quyền hạn của từng người dùng trước khi tìm kiếm. | Không thể. Ai được dùng mô hình cũng đều tiếp cận được toàn bộ dữ liệu đã học. | Khó quản lý khi chia sẻ phiên làm việc chung. |
Chiến lược kết hợp tối ưu: Các chuyên gia đầu ngành tại OpenAI và Anthropic đều khuyến nghị: Không nên xem RAG và Fine-tuning là hai đối thủ loại trừ nhau. Trong các dự án thực tế quy mô lớn, giải pháp hoàn hảo nhất thường là Fine-tuning mô hình để nắm vững văn phong, cách hành văn và định dạng JSON chuyên biệt, sau đó kết hợp RAG để cấp phát dữ liệu tri thức tươi mới và chính xác theo thời gian thực.
7. Các cấp độ tiến hóa của kiến trúc RAG trong thực tế
Kiến trúc RAG không dừng lại ở mức độ cơ bản mà đã phát triển qua ba giai đoạn tiến hóa rõ rệt để giải quyết các bài toán ngày càng hóc búa của thế giới thực:
Cấp độ 1: Naive RAG (RAG ngây thơ)
Đây là kiến trúc RAG thời kỳ đầu: Cắt đoạn thô -> Tạo vector -> Tìm kiếm Top-K bằng Cosine Similarity -> Nhét vào prompt. Kiến trúc này hoạt động tốt với các bản demo nhỏ nhưng nhanh chóng bộc lộ các yếu điểm nghiêm trọng khi ra môi trường sản xuất:
- Độ chính xác truy xuất kém: Tìm kiếm ngữ nghĩa thuần túy có thể bỏ sót các từ khóa chuyên ngành, mã lỗi kỹ thuật hoặc tên riêng viết tắt.
- Ô nhiễm ngữ cảnh (Context Noise): Các chunk tìm được có thể chứa quá nhiều thông tin rác không liên quan, khiến LLM bị phân tâm và trả lời lan man.
- Hiện tượng “Lost in the Middle”: Các nghiên cứu từ Đại học Stanford chỉ ra rằng LLM chú ý tốt nhất vào phần đầu và phần cuối của đoạn ngữ cảnh, và rất dễ bỏ qua thông tin quan trọng nằm ở đoạn giữa.
Cấp độ 2: Advanced RAG (RAG nâng cao)
Để khắc phục các điểm yếu trên, Advanced RAG bổ sung các kỹ thuật tinh vi trước và sau khi truy xuất:
- Tiền truy xuất (Pre-retrieval):
- Query Rewriting: Dùng một LLM nhỏ viết lại câu hỏi của người dùng để trở nên mạch lạc, rõ ràng và giàu ngữ nghĩa hơn trước khi gửi sang cơ sở dữ liệu vector.
- HyDE (Hypothetical Document Embeddings): Yêu cầu LLM sinh ra một câu trả lời giả định cho câu hỏi, sau đó lấy vector của câu trả lời giả định này đi tìm tài liệu thực tế. Phương pháp này mang lại độ khớp ngữ nghĩa cao vượt trội so với việc dùng vector của một câu hỏi ngắn ngủn.
- Hybrid Search: Kết hợp song song giữa tìm kiếm từ khóa truyền thống (BM25) và tìm kiếm ngữ nghĩa vector (Dense Retrieval) để vừa bắt đúng từ khóa mã định danh, vừa hiểu được ý đồ ngữ nghĩa sâu xa.
- Hậu truy xuất (Post-retrieval):
- Reranking (Xếp hạng lại): Sau khi Vector DB trả về Top-20 hoặc Top-50 kết quả tiềm năng, một mô hình phân loại chuyên sâu (Cross-Encoder như Cohere Rerank hoặc BGE-Reranker) sẽ chấm điểm lại mức độ phù hợp thực tế của từng đoạn văn đối với câu hỏi gốc, lọc lấy Top-5 đoạn tinh túy nhất.
- Context Compression (Nén ngữ cảnh): Cắt gọt các câu không liên quan trong từng chunk, chỉ giữ lại các câu mang thông tin giá trị nhất để nạp vào prompt, giúp tiết kiệm token và tăng tốc độ xử lý.
Cấp độ 3: Modular RAG & GraphRAG (RAG dạng mô-đun và Đồ thị tri thức)
Đây là đỉnh cao hiện tại của công nghệ RAG, mở ra khả năng suy luận liên kết phức tạp mà vector search truyền thống bất lực:
- GraphRAG: Được tiên phong bởi Microsoft Research, kỹ thuật này kết hợp cơ sở dữ liệu vector với Đồ thị tri thức (Knowledge Graph). Thay vì chỉ lưu trữ các đoạn văn rời rạc, hệ thống trích xuất các thực thể (Entities: người, địa danh, khái niệm) và các mối quan hệ (Relationships) giữa chúng. Khi người dùng hỏi một câu hỏi đòi hỏi suy luận đa bước (Multi-hop Reasoning) như “Chiến lược đầu tư của công ty A có ảnh hưởng thế nào đến các đối tác của công ty B tại thị trường Việt Nam?”, GraphRAG có thể lần theo các mắt xích đồ thị để gom đủ bức tranh toàn cảnh.
- Agentic RAG: Hệ thống được điều khiển bởi một tác tử AI (AI Agent). Nếu lần truy xuất đầu tiên chưa thu thập đủ thông tin để trả lời câu hỏi hóc búa, Agent sẽ tự động đánh giá sự thiếu sót, tự đặt ra các câu hỏi phụ, kích hoạt tìm kiếm lần thứ hai hoặc thứ ba trước khi tổng hợp câu trả lời cuối cùng cho người dùng.
8. Các ứng dụng thực tế bùng nổ của RAG trong doanh nghiệp
Nhờ khả năng biến tri thức tĩnh thành các trợ lý tương tác thông minh, RAG đang được triển khai mạnh mẽ trên hầu hết các lĩnh vực kinh tế – xã hội:
- Chăm sóc khách hàng thông minh (Customer Support): Chatbot không còn trả lời theo kịch bản cứng nhắc kiểu “bấm phím 1, phím 2” mà có thể đọc toàn bộ danh mục sản phẩm, chính sách bảo hành, hoàn tiền và lịch sử giao dịch để giải đáp thắc mắc khách hàng tự nhiên và chính xác 24/7.
- Quản trị tri thức nội bộ doanh nghiệp (Internal Enterprise Brain): Nhân viên mới không cần mất hàng tuần đọc hàng nghìn trang tài liệu quy trình, sổ tay nhân sự hay hướng dẫn kỹ thuật. Họ chỉ cần hỏi trợ lý RAG nội bộ: “Quy trình xin thanh toán chi phí công tác quý này gồm những bước nào?” và nhận được hướng dẫn chi tiết kèm liên kết biểu mẫu trong 2 giây.
- Trợ lý pháp lý và rà soát hợp đồng (Legaltech): Các công ty luật sử dụng RAG để quét qua hàng nghìn văn bản quy phạm pháp luật, án lệ và hợp đồng kinh tế phức tạp, giúp các luật sư phát hiện các điều khoản xung đột hoặc rủi ro pháp lý tiềm ẩn chỉ trong chớp mắt.
- Y tế và Dược phẩm (Healthcare): Hỗ trợ các y bác sĩ tra cứu nhanh các nghiên cứu lâm sàng mới nhất, hướng dẫn điều trị của Bộ Y tế và kiểm tra tương tác thuốc phức tạp, nâng cao chất lượng chẩn đoán và điều trị bệnh nhân.
- Hỗ trợ kỹ thuật phần mềm (Developer Copilot): Kết nối trực tiếp với kho tài liệu API nội bộ, tài liệu kiến trúc vi dịch vụ (microservices) và cơ sở mã nguồn (codebase) của công ty, giúp lập trình viên tra cứu cú pháp và cách sử dụng các hàm nội bộ thuận tiện hơn bao giờ hết.
9. Những thách thức kỹ thuật và cạm bẫy khi triển khai RAG thực tế
Xây dựng một bản demo RAG bằng LangChain hay LlamaIndex chỉ mất 30 phút, nhưng đưa một hệ thống RAG vào môi trường vận hành thực tế phục vụ hàng nghìn người dùng đòi hỏi phải vượt qua 4 bài toán kỹ thuật gai góc:
1. Cạm bẫy “Rác vào thì Rác ra” (Garbage In, Garbage Out)
Nếu tài liệu nguồn của doanh nghiệp chứa thông tin lỗi thời, dữ liệu mâu thuẫn giữa hai văn bản ban hành ở hai thời điểm khác nhau, hoặc tệp PDF scan mờ bị nhận diện sai ký tự (OCR lỗi), hệ thống RAG chắc chắn sẽ đưa ra câu trả lời sai lệch. Khâu tiền xử lý, làm sạch và quản trị vòng đời dữ liệu (Data Governance) luôn chiếm tới 60% tổng thời gian dự án.
2. Phân quyền dữ liệu (Role-Based Access Control – RBAC)
Trong một doanh nghiệp, không phải nhân viên nào cũng có quyền xem mọi tài liệu. Nếu một nhân viên thử việc hỏi chatbot RAG: “Bảng lương và thưởng quý này của ban giám đốc là bao nhiêu?”, hệ thống phải biết từ chối ngay ở cấp độ truy xuất vector bằng cách lọc metadata theo quyền hạn tài khoản (User Roles & Permissions), thay vì để tài liệu nhạy cảm lọt vào prompt của LLM.
3. Đánh giá chất lượng RAG (RAG Evaluation)
Làm sao để biết hệ thống RAG hôm nay hoạt động tốt hơn hôm qua? Bạn không thể dựa vào cảm tính cá nhân. Các kỹ sư phải thiết lập bộ khung đánh giá tự động (như Ragas, TruLens) đo lường bộ ba chỉ số vàng (The RAG Triad):
- Faithfulness (Tính trung thực): Câu trả lời sinh ra có thực sự dựa trên ngữ cảnh được cung cấp hay do LLM tự suy diễn?
- Answer Relevance (Mức độ phù hợp của câu trả lời): Câu trả lời có giải quyết đúng và trúng trọng tâm thắc mắc của người dùng không?
- Context Precision & Recall (Độ chính xác và độ bao phủ của ngữ cảnh): Các đoạn văn bản do Vector DB tìm về có chứa đầy đủ thông tin cần thiết và có bị thừa thãi thông tin rác hay không?
4. Cân đối giữa chi phí, độ trễ và khả năng mở rộng
Thêm nhiều bước xử lý (Reranking, Query Expansion, Multi-hop) sẽ giúp câu trả lời chính xác hơn nhưng lại làm tăng độ trễ (latency) của hệ thống lên 5-10 giây cho mỗi lượt chat, đồng thời ngốn nhiều chi phí API. Người kiến trúc sư hệ thống phải tìm được điểm cân bằng hoàn hảo giữa trải nghiệm tốc độ của người dùng và độ sâu chuyên môn của câu trả lời.
10. Câu hỏi thường gặp (FAQ) về kỹ thuật RAG
1. RAG có thể triệt tiêu hoàn toàn 100% ảo giác của AI không?
Câu trả lời thẳng thắn là không hoàn toàn 100%, nhưng RAG có thể giảm thiểu hiện tượng ảo giác tới 90-95% nếu được thiết kế chuẩn mực. Vẫn có một tỷ lệ nhỏ mô hình hiểu sai ngữ cảnh phức tạp hoặc cố tình suy diễn khi ngữ cảnh được cung cấp không đầy đủ. Để khắc phục, prompt cần có chỉ dẫn nghiêm ngặt: “Nếu ngữ cảnh không có thông tin, hãy trả lời thẳng thắn là không biết, tuyệt đối không suy đoán.”
2. Doanh nghiệp vừa và nhỏ (SME) có thể tự triển khai RAG với chi phí thấp không?
Hoàn toàn có thể. Nhờ hệ sinh thái mã nguồn mở phát triển vượt bậc, một doanh nghiệp SME có thể dựng hệ thống RAG hoàn chỉnh bằng cách kết hợp: LlamaIndex hoặc LangChain (framework điều phối), PostgreSQL với extension pgvector hoặc Qdrant Community (Vector DB miễn phí), và các mô hình embedding mã nguồn mở như BGE-M3 kết hợp mô hình ngôn ngữ Llama 3 hoặc dịch vụ API chi phí thấp từ OpenAI/Anthropic. Chi phí ban đầu chỉ từ vài chục USD mỗi tháng.
3. Tôi nên chọn Vector Database chuyên dụng hay dùng pgvector trên PostgreSQL?
Nếu doanh nghiệp của bạn đã có sẵn hạ tầng PostgreSQL và kho dữ liệu dưới 1 triệu vector với các truy vấn RAG ở mức độ thông thường, pgvector là lựa chọn thông minh nhất vì giúp tinh gọn hạ tầng và tận dụng kỹ năng quản trị sẵn có. Tuy nhiên, nếu bạn cần xử lý hàng chục triệu vector, đòi hỏi tốc độ phản hồi tính bằng mili-giây, hoặc cần tính năng Hybrid Search kết hợp lọc payload phức tạp, các cơ sở dữ liệu chuyên dụng như Qdrant hoặc Milvus sẽ vượt trội hoàn toàn.
4. Tìm kiếm ngữ nghĩa (Semantic Search) có thể thay thế hoàn toàn tìm kiếm từ khóa (BM25)?
Không. Tìm kiếm ngữ nghĩa rất xuất sắc khi hiểu ý niệm trừu tượng, nhưng lại rất kém khi người dùng tìm kiếm chính xác các chuỗi ký tự đặc biệt, như mã hợp đồng (HD-2026-X9), số hiệu model phần cứng (RTX-4090-OC), hay địa chỉ email. Vì vậy, xu hướng chuẩn mực hiện đại là Hybrid Search (Tìm kiếm lai): kết hợp cả điểm số BM25 và điểm số Vector Cosine để đạt hiệu quả tối đa trên mọi dạng câu hỏi.
5. GraphRAG có điểm gì vượt trội và khi nào nên nâng cấp lên GraphRAG?
GraphRAG vượt trội hơn RAG thông thường khi trả lời các câu hỏi mang tính tổng quan, so sánh vĩ mô hoặc suy luận đa tầng xuyên suốt nhiều tài liệu độc lập (ví dụ: “Tổng hợp các rủi ro pháp lý chung trên toàn bộ các dự án bất động sản của tập đoàn trong 3 năm qua”). Nếu hệ thống RAG của bạn chỉ phục vụ tra cứu sự kiện đơn lẻ (Factoid Q&A), RAG thông thường là đủ; bạn chỉ nên nâng cấp lên GraphRAG khi cần giải quyết bài toán phân tích liên kết tri thức phức tạp.
6. Làm thế nào để RAG xử lý dữ liệu dạng bảng biểu (Tables) chính xác?
Bảng biểu trong tệp PDF hoặc Word là “cơn ác mộng” của mô hình Embedding vì khi bị làm phẳng thành văn bản thô, cấu trúc hàng – cột bị phá vỡ. Để giải quyết, bạn nên sử dụng các công cụ trích xuất tài liệu chuyên sâu (như Unstructured, LlamaParse hoặc Microsoft MarkItDown) để chuyển đổi bảng thành định dạng Markdown Table hoặc HTML Table, kèm theo việc yêu cầu một LLM viết một đoạn tóm tắt ngắn giải thích nội dung bảng để nhúng vào metadata của chunk.
11. Lời kết: Đưa tri thức doanh nghiệp vào kỷ nguyên AI thông minh
RAG (Retrieval-Augmented Generation) không chỉ đơn thuần là một trào lưu công nghệ nhất thời, mà là một bước chuyển dịch kiến trúc mang tính nền tảng. RAG đã giải quyết xuất sắc mâu thuẫn lớn nhất của trí tuệ nhân tạo tạo sinh: làm sao để khai thác sức mạnh ngôn ngữ diệu kỳ của các siêu mô hình AI mà vẫn kiểm soát tuyệt đối tính chính xác, tính cập nhật và sự an toàn của dữ liệu riêng tư.
Một tổ chức thành công trong kỷ nguyên số không phải là tổ chức sở hữu mô hình AI lớn nhất, mà là tổ chức biết cách kết nối thông minh giữa mô hình AI với kho tri thức độc bản tích lũy qua nhiều năm hoạt động của mình. Hãy bắt đầu từ việc làm sạch kho tài liệu nội bộ, lựa chọn một chiến lược phân đoạn phù hợp và xây dựng các bản thử nghiệm PoC ngay hôm nay.
Bạn muốn khám phá thêm các xu hướng công nghệ trí tuệ nhân tạo tiên phong, hướng dẫn kỹ thuật chuyên sâu và các giải pháp thực chiến từ chuyên gia? Hãy theo dõi ngay chuyên mục AI trên TrungTien.net để cập nhật những tri thức mới nhất mỗi ngày!