Temperature trong AI là gì? Nó ảnh hưởng thế nào đến câu trả lời?
Nếu bạn từng sử dụng các công cụ trí tuệ nhân tạo như ChatGPT, Claude hay Google Gemini, chắc hẳn bạn đã nhận ra một hiện tượng thú vị: cùng một câu hỏi đầu vào, mỗi lần bấm gửi lại có thể nhận về một câu trả lời hoàn toàn khác nhau. Khi bạn viết code hoặc yêu cầu giải toán, AI có xu hướng phản hồi mạch lạc, chính xác và nhất quán. Nhưng khi bạn yêu cầu sáng tác thơ ca, viết truyện hoặc lên ý tưởng marketing, nội dung trả về lại mang tính ngẫu hứng, đầy màu sắc sáng tạo và bất ngờ.
Cơ chế điều khiển hành vi này của các mô hình ngôn ngữ lớn (LLM – Large Language Model) không phải là phép thuật thần bí. Trong thế giới kỹ thuật của trí tuệ nhân tạo, nhà phát triển có một “núm vặn” quyền năng để kiểm soát ranh giới giữa tính chính xác kỷ luật và sự ngẫu hứng phóng khoáng. Núm vặn đó mang tên Temperature (Nhiệt độ).
Dù mang tên gọi mượn từ vật lý nhiệt động lực học, Temperature trong AI thực chất là một tham số toán học kiểm soát mức độ ngẫu nhiên của thuật toán lấy mẫu xác suất. Hiểu rõ bản chất của Temperature không chỉ giúp các kỹ sư phần mềm tối ưu hóa chi phí và chất lượng ứng dụng qua API, mà còn giúp bất kỳ ai làm việc với AI biết cách làm chủ phản hồi của máy tính để phục vụ tốt nhất mục tiêu công việc. Để khám phá thêm các bài viết nền tảng và kỹ thuật chuyên sâu khác, bạn có thể tham khảo thêm tại chuyên mục AI trên trungtien.net.
1. Bản chất mô hình ngôn ngữ: AI thực sự sinh ra văn bản như thế nào?
Để hiểu Temperature can thiệp vào đâu, trước hết chúng ta cần làm sáng tỏ cách thức một mô hình ngôn ngữ lớn như GPT-4, Claude 3.5 Sonnet hay Llama 3 tạo ra câu từ. Rất nhiều người lầm tưởng rằng AI suy nghĩ trọn vẹn cả đoạn văn trong đầu rồi mới gõ ra màn hình. Trên thực tế, về mặt toán học, các mô hình ngôn ngữ hoạt động dựa trên cơ chế Dự đoán từ tiếp theo (Next-Token Prediction).
Văn bản khi đưa vào mô hình sẽ được chia nhỏ thành các đơn vị cơ bản gọi là “token” (một token có thể là một từ, một phần của từ, hoặc thậm chí là một dấu câu). Giả sử hệ thống nhận được chuỗi ký tự ban đầu: “Thủ đô của nước Pháp là”. Nhiệm vụ duy nhất của mô hình lúc này là xác định xem token tiếp theo nên là gì.
Từ Logits thô đến Không gian xác suất
Bên trong mạng nơ-ron sâu của kiến trúc Transformer, hàng trăm lớp tính toán ma trận sẽ gán cho mỗi token trong toàn bộ từ điển (thường có kích thước từ 32.000 đến hơn 128.000 token) một điểm số thô gọi là Logit. Logit càng cao biểu thị token đó càng phù hợp với ngữ cảnh ngữ pháp và kiến thức mà mô hình đã học.
Tuy nhiên, các điểm số Logit này là những con số thực bất kỳ (chẳng hạn 12.4, 8.1, -3.2) và không thể cộng lại thành 100%. Để biến các con số thô này thành một phân phối xác suất có ý nghĩa (nghĩa là mỗi token có một tỉ lệ phần trăm được chọn, và tổng tất cả các tỉ lệ bằng 1 hay 100%), mô hình bắt buộc phải đi qua một hàm toán học chuẩn mực: hàm Softmax.
Chính tại giao điểm giữa Logit và hàm Softmax này, tham số Temperature xuất hiện như một bộ chia quyền lực, làm biến đổi hoàn toàn diện mạo của bảng phân phối xác suất trước khi hệ thống đưa ra quyết định chọn từ.
2. Toán học trực quan đằng sau Temperature: Cách Softmax vận hành
Đừng để thuật ngữ toán học làm bạn e ngại. Bản chất của công thức Temperature vô cùng thanh lịch và trực quan. Hãy cùng mổ xẻ cơ chế này qua lăng kính đại số đơn giản.
Công thức hàm Softmax tiêu chuẩn chuyển đổi điểm Logit $z_i$ của token thứ $i$ thành xác suất $P(x_i)$ được biểu diễn như sau:
P(x_i) = exp(z_i) / sum_j(exp(z_j))Khi đưa thêm tham số Temperature (ký hiệu là $T$, trong đó $T > 0$) vào quá trình tính toán, mỗi điểm Logit sẽ được chia cho $T$ trước khi đưa vào hàm mũ $\exp$:
P(x_i) = exp(z_i / T) / sum_j(exp(z_j / T))Nhìn vào vị trí của $T$ nằm ở mẫu số của phép chia $z_i / T$, chúng ta có thể dễ dàng suy ra tác động cơ học của nó đối với toàn bộ kết quả:
- Khi T tiến gần về 0 (Nhiệt độ cực thấp): Phép chia $z_i / T$ làm cho các điểm số Logit bị phóng đại lên rất nhiều lần. Sự chênh lệch dù chỉ là 0.5 điểm giữa token đứng đầu và token đứng thứ hai cũng sẽ bị lũy thừa hóa thành một vực sâu thăm thẳm. Kết quả là token có điểm số cao nhất sẽ áp đảo hoàn toàn với xác suất xấp xỉ 100%, trong khi tất cả các token còn lại bị dìm xuống gần 0%. Đây chính là trạng thái lấy mẫu tham lam (Greedy Decoding).
- Khi T = 1.0 (Nhiệt độ phòng – Baseline): Điểm Logit được chia cho 1, tức là giữ nguyên trạng thái tính toán tự nhiên của mô hình. Phân phối xác suất phản ánh chính xác những gì mạng nơ-ron học được trong quá trình huấn luyện tiền khả thi (pre-training) và tinh chỉnh chỉ dẫn (instruction fine-tuning).
- Khi T > 1.0 (Nhiệt độ cao): Phép chia $z_i / T$ làm cho mọi điểm số Logit bị co lại, thu hẹp khoảng cách điểm số giữa ứng viên đứng đầu và các ứng viên phía sau. Hàm mũ biến các con số đã bị làm phẳng này thành một đồ thị phân phối xác suất thoai thoải (flattened distribution). Lúc này, các token hiếm gặp, ít có liên hệ trực tiếp bỗng nhiên nhận được cơ hội lớn hơn để được mô hình lựa chọn.
- Khi T tiến đến vô cực: Mọi giá trị $z_i / T$ đều tiệm cận về 0, dẫn đến $\exp(0) = 1$. Mọi token trong từ điển đều có xác suất xuất hiện ngang bằng nhau. Kết quả sinh ra sẽ là một chuỗi ký tự ngẫu nhiên hoàn toàn vô nghĩa (pure white noise).
Bảng ví dụ trực quan về sự dịch chuyển xác suất
Hãy tưởng tượng mô hình nhận được câu lệnh: “Thủ đô của nước Pháp là…”. Hệ thống tính toán ra điểm Logits thô cho 5 token ứng viên tiêu biểu: “Paris” (10.0), “Lyon” (6.0), “Marseille” (4.0), “chuối” (1.0), “máy tính” (0.5). Hãy xem xác suất phần trăm thay đổi ngoạn mục như thế nào khi chúng ta vặn núm Temperature từ thấp đến cao:
| Token ứng viên | Logit thô | Xác suất (T = 0.2) | Xác suất (T = 0.7) | Xác suất (T = 1.0) | Xác suất (T = 2.0) |
|---|---|---|---|---|---|
| Paris | 10.0 | 99.99% | 99.64% | 98.11% | 86.42% |
| Lyon | 6.0 | < 0.01% | 0.33% | 1.79% | 11.69% |
| Marseille | 4.0 | 0.00% | 0.03% | 0.24% | 4.30% |
| chuối | 1.0 | 0.00% | 0.00% | 0.01% | 0.96% |
| máy tính | 0.5 | 0.00% | 0.00% | 0.01% | 0.75% |
Nhìn vào bảng số liệu trên, sự thật trở nên sáng tỏ: Ở $T = 0.2$, khả năng mô hình chọn bất kỳ từ nào ngoài “Paris” gần như bằng 0. Nhưng khi đẩy lên $T = 2.0$, xác suất chọn “Lyon” đã tăng vọt lên tới 11.69%, và thậm chí một từ hoàn toàn phi lý như “chuối” cũng có gần 1% cơ hội được in ra màn hình! Đó chính là lý do vì sao Temperature cao thường dẫn đến hiện tượng câu trả lời kỳ quặc hoặc ảo giác.
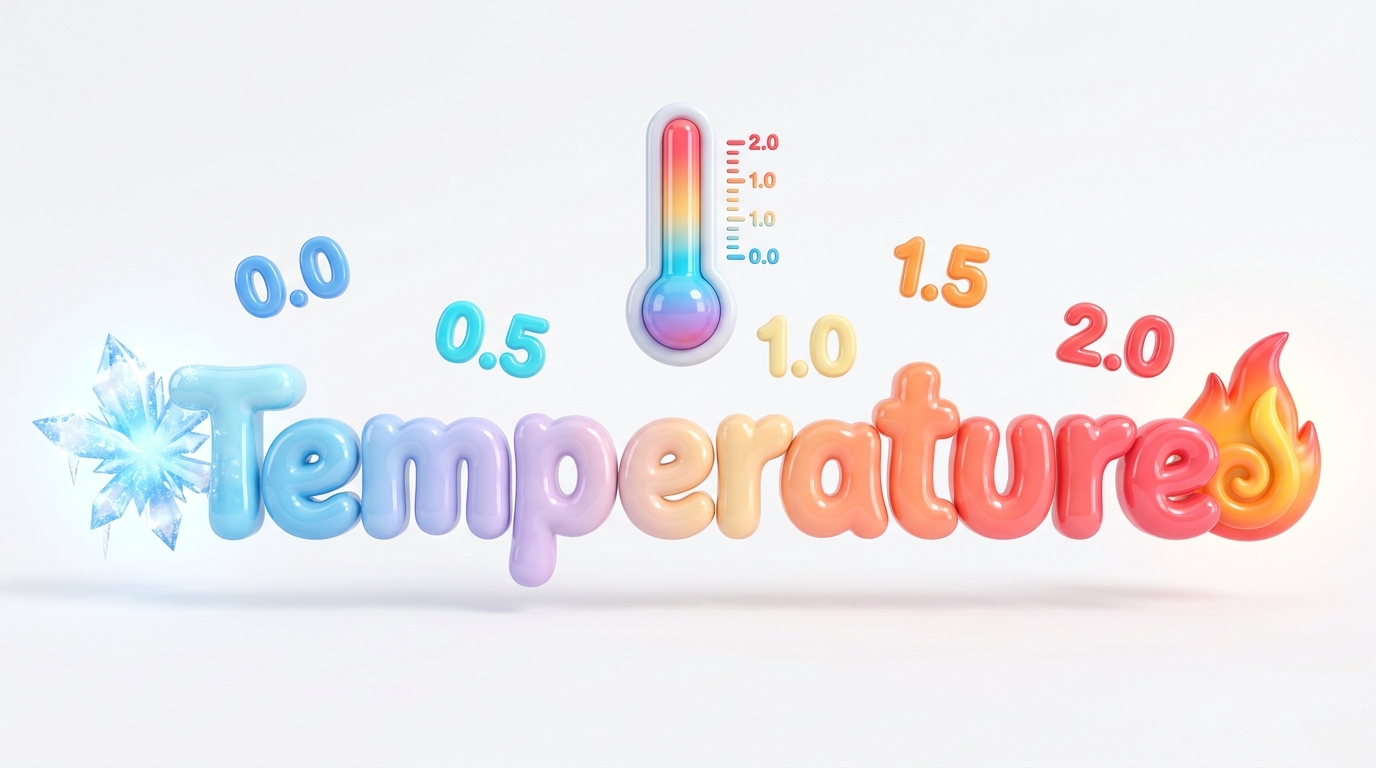
3. So sánh thực tế: Temperature 0 vs 0.5 vs 1.0 vs 2.0
Để hình dung sinh động hơn về tác động của Temperature trong đời sống hàng ngày, chúng ta hãy đặt bốn mức giá trị này vào cùng một ngữ cảnh thử nghiệm cụ thể. Hãy tưởng tượng bạn gửi tới AI một câu yêu cầu sáng tạo: “Hãy viết một câu mở đầu hấp dẫn cho cuốn tiểu thuyết viễn tưởng về một thành phố dưới đáy đại dương.”
Temperature = 0.0: Kẻ tuân thủ kỷ luật tuyệt đối (Greedy Decoding)
Khi thiết lập Temperature bằng 0, mô hình kích hoạt chế độ “Greedy Search” (Tìm kiếm tham lam). Ở mỗi bước sinh token, nó bắt buộc phải chọn token có xác suất cao nhất tuyệt đối, không có bất kỳ yếu tố xúc xắc may rủi nào được phép can thiệp.
Kết quả phản hồi thực tế:
“Thành phố Thalassopolis nằm sâu ba ngàn mét dưới đáy biển Atlantic, nơi ánh sáng mặt trời vĩnh viễn không thể chạm tới.”
Nhận xét: Câu trả lời rất chuẩn xác, câu từ gãy gọn, ngữ pháp mẫu mực và mang tính kinh điển. Nếu bạn chạy lại prompt này 100 lần ở $T=0$, hầu như cả 100 lần bạn đều nhận được đúng một câu trả lời y hệt từng dấu chấm phẩy. Tuy nhiên, tính sáng tạo ở đây ở mức tối thiểu, thiếu đi sự bất ngờ.
Temperature = 0.5: Điểm vàng cân bằng (The Sweet Spot)
Đây là khoảng nhiệt độ dung hòa tuyệt vời nhất giữa tính kỷ luật và sự linh hoạt trong ngôn ngữ. Mô hình vẫn tập trung vào các từ có điểm số cao, nhưng thỉnh thoảng cho phép những từ đồng nghĩa thú vị hoặc các cấu trúc câu mềm mại hơn được chen chân vào.
Kết quả phản hồi thực tế:
“Ẩn mình dưới áp lực nghẹt thở của vực thẳm Mariana, vòm kính khổng lồ của Neptune City tỏa ra ánh sáng lân tinh xanh biếc, che chở cho những cư dân cuối cùng của nền văn minh mặt đất.”
Nhận xét: Ngôn từ trở nên sống động, có chất thơ và chiều sâu cảm xúc rõ rệt, nhưng nội dung vẫn giữ được tính mạch lạc, cấu trúc ngữ pháp chặt chẽ và không có bất kỳ dấu hiệu ngớ ngẩn nào.
Temperature = 1.0: Nghệ sĩ tự do và Trí tưởng tượng bay bổng
Ở mức 1.0, AI bắt đầu chấp nhận rủi ro. Các mối liên kết ý tưởng xa xôi hơn trong mạng nơ-ron được kích hoạt. Bạn sẽ thấy những hình ảnh so sánh độc đáo, những tính từ bất ngờ mà một nhà văn thông thường cũng phải mất nhiều thời gian suy ngẫm.
Kết quả phản hồi thực tế:
“Trong dạ dày đen đặc của rãnh nứt đại dương, thành phố Thủy Tinh thở bằng lá phổi nhân tạo khổng lồ, nơi mỗi nhịp đập cơ khí đều rung chuyển theo điệu múa của bầy cá phát quang săn mồi.”
Nhận xét: Rất ấn tượng và khơi gợi trí tưởng tượng mạnh mẽ. Tuy nhiên, ở mức nhiệt độ này, nếu bạn yêu cầu một bài toán logic hoặc đoạn mã lập trình phức tạp, AI rất dễ phạm sai lầm nhỏ vì nó ưu tiên sự mới lạ hơn là tuân thủ chặt chẽ cú pháp.
Temperature = 2.0: Vùng đất hỗn loạn và Sự sụp đổ cú pháp
Khi đẩy Temperature lên cực hạn của thang đo, phân phối xác suất bị san phẳng hoàn toàn. Mọi từ ngữ đều có cơ hội xuất hiện ngang nhau, bất chấp logic ngữ nghĩa hay trật tự từ.
Kết quả phản hồi thực tế:
“Dưới vỏ sò đại dương lơ lửng xung điện ba chiều, cá voi sắt ngân vang bánh mì đồng hồ… sương mù thủy triều rách rưới thở ra những tinh vân lục lam.”
Nhận xét: Cú pháp bắt đầu gãy đổ, các danh từ không liên quan ghép lại với nhau một cách kỳ dị. Đây là biểu hiện kinh điển của hiện tượng quá nhiệt (overheating) trong mô hình ngôn ngữ lớn.
4. Khi nào nên dùng Temperature thấp và khi nào nên dùng Temperature cao?
Hiểu được lý thuyết là một chuyện, nhưng nghệ thuật ứng dụng AI vào thực tế nằm ở việc biết chọn đúng giá trị Temperature cho từng mục đích công việc cụ thể. Sử dụng sai mức Temperature có thể phá hỏng hoàn toàn một dự án tự động hóa hoặc làm giảm hiệu suất làm việc của bạn.
Trường hợp nên sử dụng Temperature thấp (0.0 đến 0.3)
Temperature thấp được sinh ra để phục vụ các bài toán đòi hỏi tính tất định (deterministic), độ chính xác tuyệt đối, sự thật khách quan và tính lặp lại có thể kiểm chứng được. Trong các tác vụ này, sự “sáng tạo” đồng nghĩa với rủi ro và sai hỏng:
- Lập trình và Viết Code phần mềm: Cú pháp lập trình (Python, JavaScript, Rust, SQL…) cực kỳ nhạy cảm. Chỉ một dấu ngoặc đặt sai vị trí hay một tên hàm bị biến thể cũng sẽ khiến chương trình bị crash ngay lập tức. Đặt $T = 0.0$ đến $0.1$ giúp AI chọn đúng các cấu trúc thuật toán chuẩn tắc nhất.
- Trích xuất dữ liệu có cấu trúc (JSON, XML, CSV): Khi bạn yêu cầu mô hình đọc một bản hợp đồng hay hóa đơn và xuất ra định dạng JSON tuân thủ Schema nghiêm ngặt, bạn cần $T = 0$. Bất kỳ sự bay bổng nào cũng có thể làm sai lệch trường dữ liệu (key/value) hoặc hỏng cú pháp đóng mở ngoặc nhọn.
- Dịch thuật tài liệu kỹ thuật và pháp lý: Bản dịch hợp đồng kinh tế hay sổ tay hướng dẫn y tế không cần chất thơ; chúng đòi hỏi độ chính xác tuyệt đối từng thuật ngữ chuyên ngành.
- Giải toán và Suy luận logic: Các bước chứng minh định lý hay tính toán số học cần bám sát các tiên đề logic thay vì thử nghiệm những con đường suy luận mạo hiểm.
- Hỏi đáp dựa trên tài liệu (RAG – Retrieval Augmented Generation): Khi xây dựng hệ thống hỏi đáp nội bộ cho doanh nghiệp từ kho tài liệu PDF, việc hạ Temperature xuống 0.1 – 0.2 giúp giảm thiểu tối đa hiện tượng AI bịa đặt thông tin không có trong văn bản nguồn.
Trường hợp nên sử dụng Temperature cao (0.7 đến 1.2)
Ngược lại, khi mục tiêu của bạn là phá vỡ lối mòn tư duy, tìm kiếm sự đa dạng hoặc tạo ra văn phong giàu cảm xúc, Temperature cao chính là trợ thủ đắc lực nhất:
- Brainstorming và Phát triển ý tưởng mới: Khi bạn cạn kiệt ý tưởng cho một chiến dịch quảng cáo, tên thương hiệu hay chủ đề bài viết, hãy nâng Temperature lên 0.9 – 1.0. Mô hình sẽ đưa ra những liên tưởng bất ngờ mà bạn chưa từng nghĩ tới.
- Sáng tác văn học, thơ ca và kịch bản: Để tạo ra những đoạn hội thoại sống động giữa các nhân vật với cá tính độc đáo, việc nới lỏng xác suất giúp câu từ không bị khô cứng như sách giáo khoa.
- Viết nội dung quảng cáo (Copywriting) và Mạng xã hội: Các bài đăng Facebook, TikTok caption hay tiêu đề email marketing cần sự giật gân, cuốn hút và biến hóa đa dạng để thu hút sự chú ý.
- Đóng vai (Role-playing) và Trò chơi nhập vai (NPC AI): Khi tạo bot đóng vai các nhân vật lịch sử, thần thoại hay các nhân vật trong game phiêu lưu, Temperature cao (0.8 – 1.1) giúp phản hồi của nhân vật trở nên tự nhiên, khó đoán và giàu biểu cảm như con người thực.
5. Bộ ba nguyên tử: Phối hợp Temperature, Top-P và Top-K
Nếu bạn chỉ điều chỉnh duy nhất tham số Temperature, đôi khi bạn vẫn gặp phải rắc rối. Giả sử ở nhiệt độ $T = 0.9$, mặc dù văn phong rất sáng tạo, nhưng mô hình vẫn có một tỷ lệ nhỏ chọn phải một token cực kỳ vô nghĩa nằm ở vị trí thứ 10.000 trong danh sách từ vựng. Để giải quyết triệt để vấn đề này, các nhà nghiên cứu AI đã phát minh ra hai bộ lọc bổ trợ cực kỳ quan trọng: Top-K và Top-P (Nucleus Sampling).
Top-K Sampling: Bộ lọc số lượng ứng viên cố định
Nguyên lý của Top-K rất đơn giản: Sau khi mô hình tính toán xong xác suất cho toàn bộ từ điển, hệ thống sẽ xếp hạng từ cao xuống thấp và chỉ giữ lại đúng K ứng viên đứng đầu bảng (ví dụ $K = 50$). Toàn bộ hàng chục ngàn từ còn lại sẽ bị gạch tên ngay lập tức. Sau đó, quá trình lấy mẫu mới diễn ra trong phạm vi K từ này.
Hạn chế của Top-K: Con số K mang tính cứng nhắc. Trong một số ngữ cảnh ngữ pháp rõ ràng (như câu: “Mặt trời mọc ở hướng…”), thực tế chỉ có 1 từ duy nhất đúng (“Đông”). Việc giữ lại tới 50 từ vô tình mở cửa cho những từ sai sót lọt vào. Ngược lại, trong những câu hỏi mở, việc giới hạn K = 50 có thể quá chật hẹp, bóp nghẹt sự sáng tạo.
Top-P (Nucleus Sampling): Bộ lọc tổng xác suất tích lũy động
Được đề xuất bởi các nhà nghiên cứu tại Đại học Washington và Viện AI Allen vào năm 2019, Top-P (còn gọi là Nucleus Sampling – Lấy mẫu hạt nhân) giải quyết xuất sắc nhược điểm của Top-K. Thay vì chọn một con số lượng từ cố định, Top-P chỉ giữ lại một nhóm nhỏ các token có tổng xác suất tích lũy đạt ngưỡng P (thường là $P = 0.9$ hoặc $90\%$).
Cơ chế này linh hoạt một cách kỳ diệu:
- Nếu mô hình rất tự tin (ví dụ từ đứng đầu đã chiếm 92% xác suất), nhóm hạt nhân sẽ chỉ gồm đúng 1 từ duy nhất. Các từ khác bị loại bỏ 100%.
- Nếu ngữ cảnh mơ hồ và có nhiều lựa chọn ngang ngửa nhau, nhóm hạt nhân có thể tự động mở rộng ra 10, 20 hoặc 100 từ cho đến khi tổng xác suất gom đủ 90%.
Nên kết hợp Temperature và Top-P như thế nào?
Cả hai tổ chức AI hàng đầu thế giới là OpenAI và Anthropic đều đưa ra khuyến nghị chính thức trong tài liệu kỹ thuật dành cho nhà phát triển: Thông thường, bạn chỉ nên điều chỉnh một trong hai tham số (Temperature hoặc Top-P), và giữ nguyên tham số còn lại ở giá trị mặc định.
Tuy nhiên, trong các hệ thống sản phẩm phức tạp, việc phối hợp tinh tế cả hai tham số có thể mang lại kết quả vượt trội:
| Mục tiêu tác vụ | Temperature | Top-P | Kết quả mong đợi |
|---|---|---|---|
| Chính xác tuyệt đối / Code / JSON | 0.0 | 1.0 (hoặc 0.1) | Câu trả lời có tính tất định, không lỗi cú pháp, bám sát sự thật. |
| Đàm thoại trợ lý / CSKH | 0.5 | 0.9 | Giọng văn tự nhiên, thân thiện, thông tin đáng tin cậy. |
| Viết bài SEO / Content Blog | 0.7 | 0.9 | Ngôn từ uyển chuyển, phong phú, không rập khuôn máy móc. |
| Brainstorming / Sáng tạo đột phá | 0.9 – 1.1 | 0.95 | Ý tưởng mới mẻ, góc nhìn độc đáo, an toàn không bị loạn ngôn. |
6. Bảng so sánh toàn diện các mức Temperature trong AI
Để giúp bạn dễ dàng tra cứu nhanh chóng mỗi khi cần cấu hình hệ thống AI hoặc viết ứng dụng gọi API, dưới đây là bảng ma trận tổng hợp chi tiết mọi khía cạnh của tham số Temperature:
| Thang Temperature | Đặc tính toán học | Mức độ ngẫu nhiên | Nguy cơ ảo giác (Hallucination) | Tính nhất quán của kết quả | Tác vụ khuyến nghị áp dụng |
|---|---|---|---|---|---|
| 0.0 – 0.2 | Logits bị phóng đại cực đại; chọn token số 1. | Cực thấp (Gần như bằng 0) | Rất thấp (Chỉ ảo giác nếu dữ liệu nguồn sai) | Cực cao (99.9% giống nhau giữa các lần chạy) | Lập trình, SQL, trích xuất dữ liệu, dịch văn bản luật, giải toán. |
| 0.3 – 0.5 | Tập trung vào top đầu, mở rộng nhẹ cho từ đồng nghĩa. | Thấp đến Trung bình | Thấp | Cao | Tóm tắt báo cáo kinh doanh, dịch sách thường thức, hỏi đáp tài liệu RAG. |
| 0.6 – 0.8 | Phân phối xác suất tự nhiên theo mô hình gốc. | Trung bình đến Khá | Trung bình | Trung bình (Mỗi lần chạy sẽ có cách diễn đạt khác) | Viết bài SEO, email tiếp thị, chatbot đối thoại, viết kịch bản video. |
| 0.9 – 1.2 | Làm phẳng phân phối; token phụ có nhiều cơ hội. | Cao | Cao | Thấp | Sáng tác văn học, thơ ca, lên ý tưởng chiến dịch truyền thông, đóng vai game. |
| 1.3 – 2.0 | Gần với phân phối ngẫu nhiên đồng đều (Uniform). | Cực cao (Hỗn loạn) | Rất cao (Nguy cơ sụp đổ ngữ pháp) | Gần như bằng 0 | Nghiên cứu học thuật về lấy mẫu xác suất, thử nghiệm hiệu ứng ngôn ngữ siêu thực. |
7. Hướng dẫn thiết lập Temperature chuẩn xác cho từng tác vụ thực tế
Khi triển khai AI vào quy trình làm việc của cá nhân hoặc doanh nghiệp, câu hỏi lớn nhất luôn là: “Với bài toán cụ thể của tôi, con số Temperature chính xác nên là bao nhiêu?” Dưới đây là bộ hướng dẫn thực chiến đã được kiểm chứng qua hàng ngàn dự án AI thực tế.
Nhóm tác vụ 1: Lập trình, Debug và Xử lý Cơ sở dữ liệu (Temperature: 0.0 – 0.2)
Trong lập trình, tính đúng đắn logic là yếu tố sống còn. Bạn không bao giờ muốn AI ngẫu hứng “sáng chế” ra một tham số mới trong thư viện React hoặc tự bịa ra một cú pháp lệnh Docker không tồn tại. Hãy luôn đặt $T = 0.0$. Ở mức này, mô hình sẽ gọi lại các mẫu mã nguồn tiêu chuẩn nhất, an toàn nhất đã được chứng minh qua hàng triệu kho lưu trữ mã nguồn mở.
Nhóm tác vụ 2: Trích xuất thông tin thực thể (NER) và Đầu ra JSON (Temperature: 0.0)
Nếu bạn đang xây dựng pipeline xử lý tài liệu tự động — ví dụ đọc hóa đơn scan và bóc tách các trường `invoice_number`, `tax_id`, `total_amount` — hãy kiên quyết cố định $T = 0.0$. Bất kỳ mức nhiệt độ nào cao hơn 0 đều có thể khiến mô hình tự động thêm các ký tự thừa, làm hỏng cấu trúc phân tích chuỗi JSON (`json.loads` trong Python sẽ báo lỗi cú pháp).
Nhóm tác vụ 3: Tóm tắt văn bản và Biên dịch ngôn ngữ (Temperature: 0.2 – 0.4)
Khi tóm tắt một bài báo dài 5.000 từ thành 3 ý chính, mức nhiệt độ 0.3 giúp AI giữ được độ trung thành tuyệt đối với thông tin trong bài viết gốc, đồng thời có đủ sự linh hoạt để sắp xếp các câu văn tóm tắt một cách tự nhiên, mạch lạc, không bị chắp vá thô cứng.
Nhóm tác vụ 4: Chatbot chăm sóc khách hàng doanh nghiệp (Temperature: 0.4 – 0.6)
Một trợ lý ảo CSKH nếu đặt $T = 0$ sẽ trở nên máy móc, trả lời như một cái máy ghi âm lặp đi lặp lại khiến người dùng khó chịu. Nhưng nếu đặt $T = 1.0$, trợ lý có thể “hứa hươu hứa vượn” những chính sách giảm giá không có thật. Khoảng 0.5 là tỉ lệ vàng: đủ ấm áp và đồng cảm trong giao tiếp, nhưng vẫn tuân thủ nghiêm ngặt chính sách công ty.
Nhóm tác vụ 5: Viết bài Content chuẩn SEO và Blog (Temperature: 0.7 – 0.8)
Viết nội dung cho người đọc đòi hỏi sự lôi cuốn, vốn từ vựng phong phú và các phép ẩn dụ sinh động. Mức nhiệt độ 0.7 cho phép AI sử dụng cách hành văn tự nhiên, tránh bị các công cụ phát hiện văn bản AI gắn cờ là nội dung máy móc rập khuôn.
Nhóm tác vụ 6: Sáng tác nghệ thuật và Brainstorming (Temperature: 0.9 – 1.1)
Khi cần nghĩ ra 20 góc nhìn khác biệt cho một vấn đề, hoặc sáng tác một bài thơ theo phong cách trừu tượng, đừng ngần ngại đẩy nhiệt độ lên quanh mức 1.0. Hãy kết hợp với $Top\_P = 0.95$ để vừa kích hoạt sự sáng tạo vô biên vừa giữ cho ngôn ngữ không bị rơi vào hỗn loạn.
8. Những sai lầm phổ biến và Hiểu lầm kinh điển về Temperature
Trong cộng đồng người dùng và thậm chí cả các kỹ sư phần mềm mới tiếp cận AI, tồn tại không ít những nhận thức sai lầm về bản chất của Temperature. Dưới đây là bốn hiểu lầm phổ biến nhất mà bạn cần tránh:
Hiểu lầm 1: “Temperature càng cao thì AI càng thông minh”
Nhiều người nghĩ rằng đẩy nhiệt độ cao sẽ khiến AI “suy nghĩ sâu sắc hơn” hoặc “uyên bác hơn”. Đây là sai lầm nghiêm trọng. Temperature hoàn toàn không thay đổi năng lực suy luận hay lượng tri thức mà mạng nơ-ron sở hữu. Nó chỉ là một bộ lọc xác suất cho từ tiếp theo. Tăng nhiệt độ quá mức không làm AI thông minh hơn, nó chỉ làm AI trở nên liều lĩnh hơn và dễ nói nhảm hơn.
Hiểu lầm 2: “Temperature = 0 sẽ loại bỏ hoàn toàn 100% ảo giác (Hallucination)”
Ảo giác trong mô hình ngôn ngữ xuất phát từ hai nguyên nhân: một là sự ngẫu nhiên khi lấy mẫu xác suất, hai là lỗ hổng trong dữ liệu huấn luyện hoặc sự liên tưởng sai lệch trong mạng trọng số. Đặt $T = 0$ chỉ loại bỏ nguyên nhân thứ nhất. Nếu mô hình đã tin chắc rằng một thông tin sai lệch là đúng (điểm logit của thông tin sai đó cao nhất), thì ngay cả ở $T = 0$, nó vẫn sẽ dõng dạc khẳng định điều sai trái đó với sự tự tin 100%.
Hiểu lầm 3: “Temperature = 0 luôn trả về một kết quả giống hệt nhau trên mọi API”
Về mặt lý thuyết toán học thuần túy, $T = 0$ là phép toán Greedy Search mang tính tất định hoàn toàn. Tuy nhiên trong môi trường sản xuất thực tế trên các cụm máy chủ đám mây (GPU clusters), bạn vẫn có thể thấy câu trả lời ở $T = 0$ hơi khác nhau đôi chút giữa các lần gọi. Nguyên nhân đến từ kỹ thuật tính toán song song trên GPU: sự sai lệch dấu phẩy động cực nhỏ (floating-point round-off error) do thứ tự cộng ma trận trong các mô hình chạy đồng thời hàng ngàn luồng có thể làm thay đổi vị trí thập phân thứ 6, thỉnh thoảng khiến một token suýt soát vượt lên.
Hiểu lầm 4: “Có một con số Temperature lý tưởng dùng chung cho tất cả”
Không có một con số vạn năng nào trong AI. Một sản phẩm phần mềm xuất sắc thường sở hữu các mức Temperature động: khi người dùng yêu cầu tra cứu tài liệu kỹ thuật, hệ thống tự động gán $T = 0.1$; khi người dùng bấm nút “Lên ý tưởng sáng tạo”, hệ thống âm thầm chuyển sang $T = 0.85$. Đó mới là cách tiếp cận thông minh của một kỹ sư AI thực thụ.
9. Cách tinh chỉnh Temperature trong môi trường lập trình thực tế
Để thấy được sự tiện lợi của việc kiểm soát Temperature, chúng ta hãy xem xét ví dụ thực tế khi gọi API của OpenAI thông qua thư viện Python. Bạn có thể dễ dàng thiết lập tham số này chỉ bằng một dòng code đơn giản:
import openai

client = openai.OpenAI(api_key="YOUR_API_KEY")

# Ví dụ 1: Nhiệm vụ lập trình cần độ chính xác tuyệt đối
code_response = client.chat.completions.create(
    model="gpt-4o",
    messages=[
        {"role": "system", "content": "Bạn là chuyên gia lập trình Python cao cấp."},
        {"role": "user", "content": "Hãy viết hàm kiểm tra số nguyên tố tối ưu nhất."}
    ],
    temperature=0.0,  # Không cho phép sự ngẫu nhiên
    top_p=1.0
)

# Ví dụ 2: Nhiệm vụ sáng tạo ý tưởng khởi nghiệp
creative_response = client.chat.completions.create(
    model="gpt-4o",
    messages=[
        {"role": "system", "content": "Bạn là cố vấn sáng tạo khởi nghiệp công nghệ."},
        {"role": "user", "content": "Hãy đề xuất 5 ý tưởng kinh doanh đột phá kết hợp AI và nông nghiệp sạch."}
    ],
    temperature=0.9,  # Mở rộng không gian sáng tạo
    top_p=0.95
)
Nếu bạn không sử dụng mã nguồn mà làm việc trực tiếp trên giao diện đồ họa, các nền tảng thử nghiệm chuyên nghiệp như OpenAI Playground, Anthropic Console hay Google AI Studio đều cung cấp thanh trượt Temperature trực quan ở cột cài đặt bên phải màn hình để bạn có thể thử nghiệm và so sánh kết quả tức thì.
10. Câu hỏi thường gặp (FAQ) về Temperature trong AI
Q1: Thuật ngữ “Temperature” trong AI có nguồn gốc từ đâu?
Khái niệm này bắt nguồn trực tiếp từ phân phối nhiệt động lực học Boltzmann trong vật lý thống kê. Trong vật lý, khi nhiệt độ của một chất khí tăng lên, các hạt phân tử chuyển động hỗn loạn hơn và có nhiều khả năng chiếm giữ các trạng thái năng lượng cao bất thường. Trong AI, kỹ thuật tôi luyện mô phỏng (Simulated Annealing) đã mượn lại nguyên lý này: hạ nhiệt độ từ từ để giúp thuật toán hội tụ về giải pháp tối ưu thay vì bị kẹt lại ở các điểm cực trị cục bộ.
Q2: Tại sao giao diện web ChatGPT thông thường không cho tôi chỉnh Temperature?
Để phục vụ hàng trăm triệu người dùng đại chúng không rành về kỹ thuật, OpenAI đã khóa cứng tham số Temperature trên giao diện web ChatGPT ở mức cân bằng mặc định (thường dao động từ 0.7 đến 0.8 tùy phiên bản model). Mức cài đặt này giúp đa số người dùng cảm thấy bot nói chuyện tự nhiên, vừa đủ thông minh và vừa đủ sáng tạo. Nếu muốn tự tay chỉnh Temperature, bạn cần chuyển sang sử dụng OpenAI Playground hoặc gọi qua API.
Q3: Tôi nên ưu tiên tinh chỉnh Temperature hay Top-P trước?
Theo thực tiễn tốt nhất trong ngành, bạn nên ưu tiên điều chỉnh Temperature trước tiên vì nó mang lại sự thay đổi rõ rệt và trực quan nhất đối với phong cách câu trả lời. Giữ $Top\_P$ ở mức 0.9 hoặc 1.0. Chỉ khi bạn gặp phải hiện tượng câu trả lời xuất hiện những từ ngữ quá xa lạ ở nhiệt độ cao, lúc đó hãy hạ $Top\_P$ xuống mức 0.85 – 0.9 để cắt tỉa phần đuôi xác suất độc hại.
Q4: Temperature có ảnh hưởng đến chi phí và số lượng Token tiêu thụ không?
Bản thân Temperature không làm tăng hay giảm đơn giá của mỗi token. Tuy nhiên, nó có thể ảnh hưởng gián tiếp đến độ dài của phản hồi. Ở nhiệt độ cao, mô hình có xu hướng dùng nhiều từ hoa mỹ hơn, diễn đạt dài dòng hơn hoặc tạo ra các liên tưởng phụ, dẫn đến số lượng token đầu ra (completion tokens) tăng lên, làm chi phí tổng thể của phiên gọi API cao hơn đôi chút.
Q5: Có thể đặt giá trị Temperature âm được không?
Không. Về mặt toán học, giá trị Temperature bắt buộc phải lớn hơn 0 ($T > 0$). Nếu đặt $T < 0$, dấu của phép chia $z_i / T$ sẽ bị đảo ngược, khiến token có điểm logit thấp nhất (tồi tệ nhất) lại biến thành token có xác suất cao nhất. Khi đó, AI sẽ sinh ra những chuỗi từ hoàn toàn vô nghĩa và sai lệch trầm trọng.
Q6: Khi nào thì tôi nên tăng Temperature vượt ngưỡng 1.5?
Hầu như không bao giờ trong các ứng dụng thực tế thông thường. Ngưỡng trên 1.5 chỉ được sử dụng trong các nghiên cứu học thuật về tính ngẫu nhiên của mô hình, hoặc trong một số dự án nghệ thuật đương đại thể nghiệm (chẳng hạn như tạo ra các bài thơ trừu tượng siêu thực Dadaism). Đối với mọi nhu cầu công việc từ viết lách, kinh doanh cho đến kỹ thuật, mức nhiệt độ từ 0.0 đến 1.0 là quá đủ để đáp ứng mọi tình huống.
11. Lời kết: Làm chủ chiếc la bàn tư duy của trí tuệ nhân tạo
Temperature không đơn thuần là một con số kỹ thuật khô khan ẩn mình sau các dòng code hay thanh trượt phần mềm. Nó chính là chiếc la bàn định vị tính cách và phương thức tư duy của trí tuệ nhân tạo. Bằng cách điều chỉnh nhiệt độ một cách có chủ đích, bạn có thể biến một mô hình ngôn ngữ lớn thành một chuyên gia phân tích logic lạnh lùng, một trợ lý hỗ trợ khách hàng ân cần chu đáo, hay một người bạn đồng hành sáng tạo đầy cảm hứng.
Hiểu rõ cơ chế hoạt động của Temperature, biết cách phối hợp nó cùng Top-P và áp dụng linh hoạt cho từng bài toán cụ thể chính là bước ngoặt giúp bạn chuyển dịch từ một người dùng AI bị động sang một kỹ sư làm chủ công nghệ thực thụ. Hãy bắt đầu thử nghiệm ngay hôm nay trên các công cụ và cảm nhận sự khác biệt kỳ diệu trong từng câu trả lời mà AI mang lại.
Để tiếp tục nâng cao kỹ năng ứng dụng AI, làm chủ kỹ thuật Prompt Engineering và cập nhật những kiến thức công nghệ đột phá nhất, đừng quên ghé thăm và theo dõi các bài viết chuyên sâu tại chuyên mục AI trên trungtien.net.